以存代算,AI 推理十倍加速,突破上下文瓶颈
ET WQS 极速 AI 语义存储
AI 原生 KV Cache Storage · 分布式 KV 缓存存储
WQS(WiDE Query Storage)由华瑞指数云(ExponTech)面向大规模 AI 推理场景全栈原生设计:以原生 KV 接口无缝对接 vLLM / SGLang 等主流推理框架,将分布式 KV Cache 存储池作为 GPU HBM 显存的透明扩展层,支持无限容量扩展与集群全局共享,为长上下文、高并发推理提供极致性能的存储底座——以存代算,突破上下文瓶颈。
20x
TTFT 加速(100K 输入实测)
22x
Token 吞吐量提升
<200μs
端到端并发读取时延
97–98%
生产环境缓存命中率
100%
DPU 原生卸载(可选)
三大创新支柱
从 KV Cache 的 IO 特征出发全栈原生设计,而非在传统存储上打补丁
AI 原生 KV 接口与 KV 引擎
「KV → 网络 → KV」原生路径:2 跳、0 次内核穿越、全用户态 RDMA 零拷贝
直管 NVMe 裸盘、统一池化,绕开文件系统的冗余 IO 路径与内核开销
16K–10M 全尺寸小 IO 保持平直满带宽,DFS 在小 IO 下带宽崩塌约 10 倍
CacheBlend 非前缀复用:序列任意位置匹配已缓存 KV,有效命中率最高达 98%+
逐层流水线加载
GPU 计算第 i 层的同时预取第 i+1 层 KV,IO 时延完全隐藏于计算
单层 KV 加载时间可低至 <10μs,SSD 与 HBM 的时延差不再构成端到端瓶颈
块粒度细至 16 tokens(比传统精细 16 倍),匹配粒度更细、命中率更高
DPU 原生架构(可选)
软件可 100% 运行于 NVIDIA BlueField DPU + JBOF,主机 CPU 零参与存储路径
无需专门存储服务器,1 个 WQS 节点 ≈ 3 台传统存储服务器等效性能
与 NVIDIA CMX 分层缓存架构完美契合,承担 G3.5 共享 KV 池层
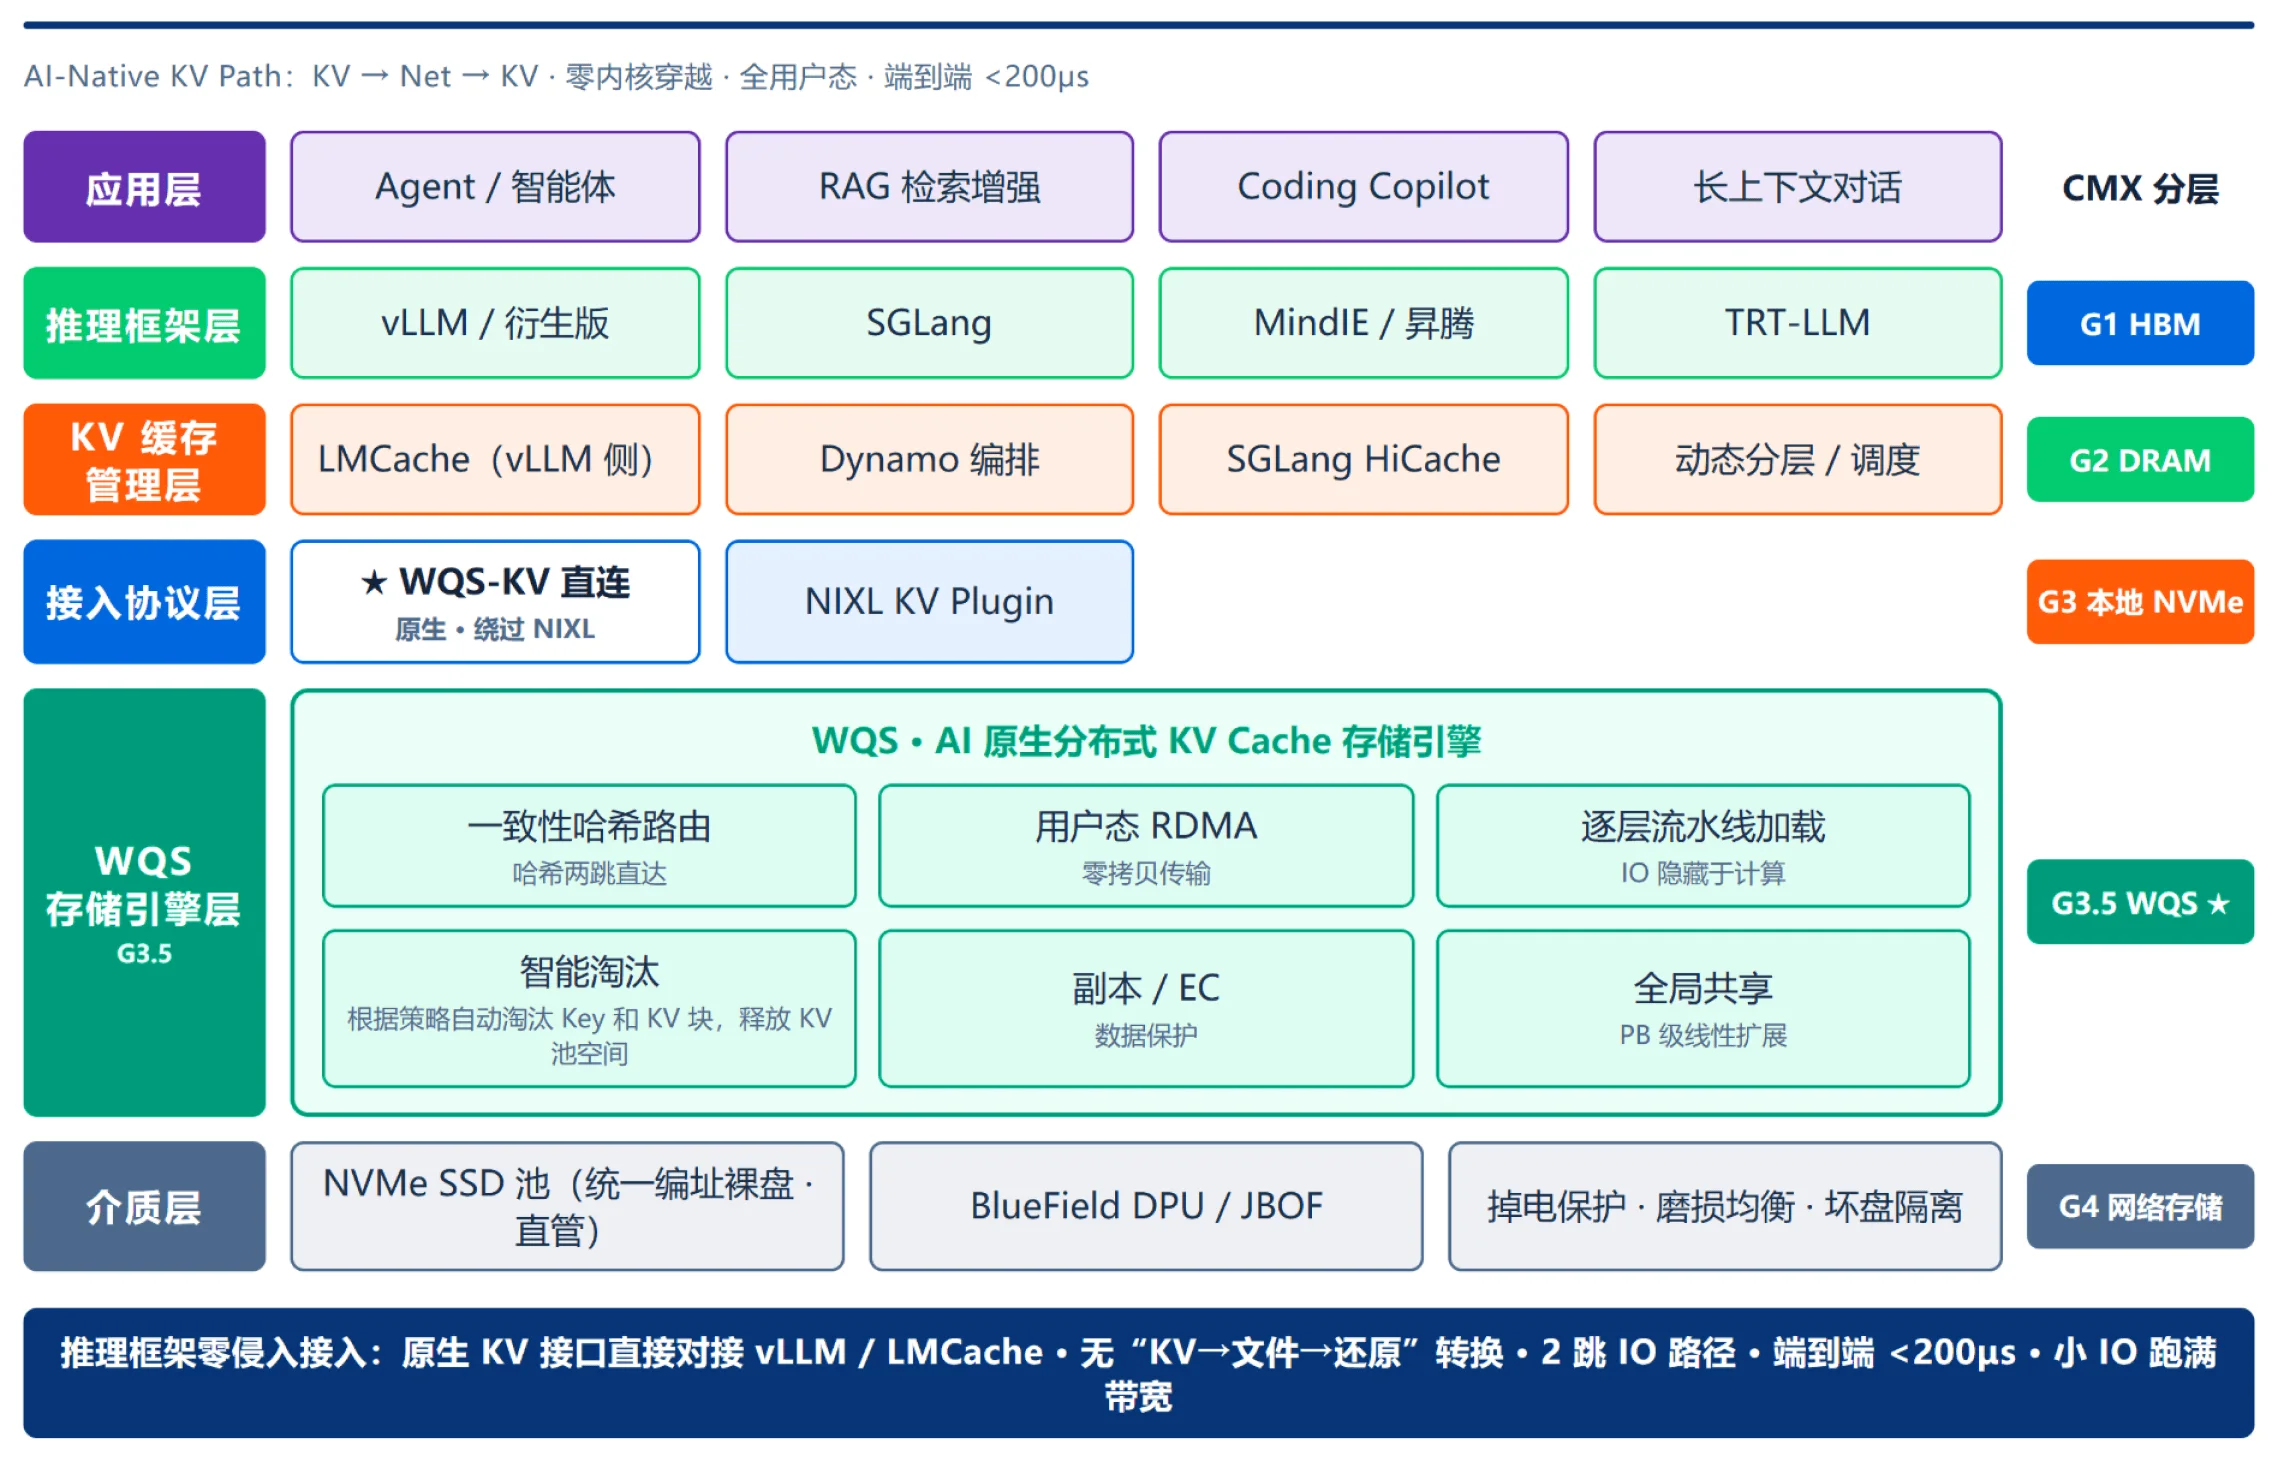
总体系统架构
应用 → 介质端到端分层:推理框架零侵入接入,端到端并发时延 <200μs
总体系统架构
实测性能
生产等价硬件上的联合测试:实验室极限场景与真实业务 A/B 对比
实验室极限场景:全量重算 vs 全量命中
DeepSeek-R1-0528 · 8× NVIDIA H20 · vLLM + LMCache · 100K token 输入
指标GPU 重算WQS 全量命中提升
TTFT(首 token 时延)323 s16s20x
Token 吞吐量4,194 tok/s90,000 tok/s22x
Token 间时延(ITL)baseline≈ 1/1212x
端到端读取时延—<200μs—
真实业务 A/B 对比:高并发多轮 Agent
GLM 4.7 355B · 30K token 系统提示词 · 多轮会话 · 30–100 并发用户 · 仅 HBM vs. HBM + WQS
并发数TTFT · 仅 HBMTTFT · HBM+WQS吞吐提升命中率
3022.38s5.03s4.5x97%
60179.56s42.19s4.4x97%
100399.35s88.03s4.7x97%
仅 HBM 在 30 并发用户时即触及“逐出悬崖”——TTFT 劣化至 399 秒。WQS 吸收超出 HBM 容量的 KV Cache,性能平稳可预期:真实业务下稳定获得 4.4–4.7× 吞吐提升与 76–78% 的 TTFT 降低。
与 vLLM + LMCache 集成
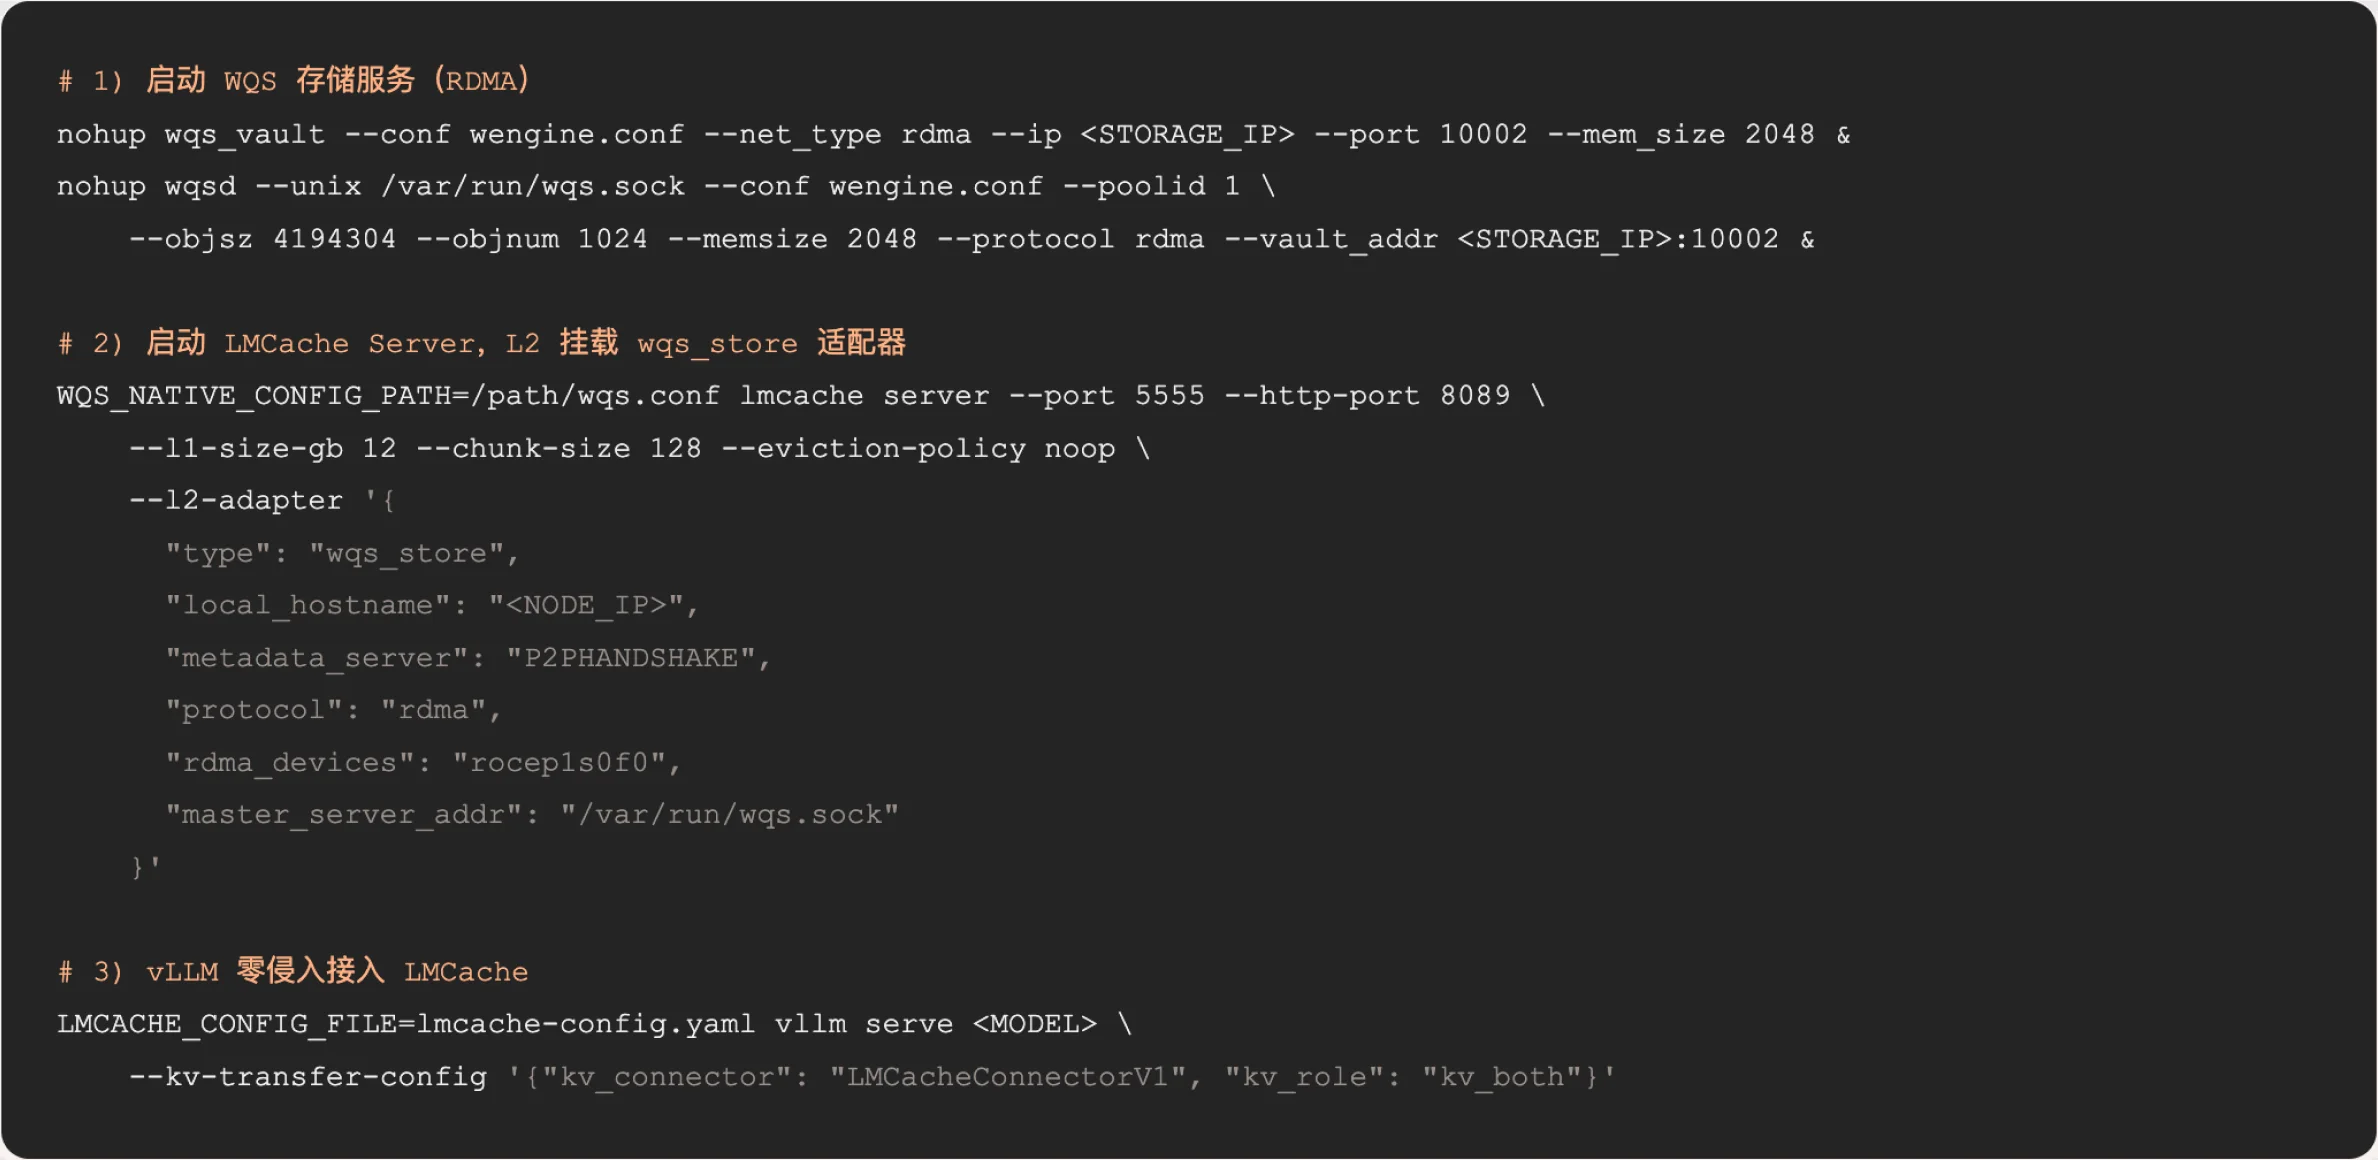
推理框架零侵入:业务侧使用原有 vLLM + LMCache 部署,三步接入 WQS 存储池
第 1 步 · 启动 WQS 存储集群
部署 wqs_vault / wqsd 存储服务(RDMA 传输、NVMe 池容量、CPU 绑核),对外提供 KV Cache 服务。
第 2 步 · 为 LMCache Server 挂载 WQS L2 适配器
启动 lmcache server 时指定 --l2-adapter type wqs_store,RDMA 直连访问存储池,L1 由 hugepage memfd 支撑。
第 3 步 · 将 vLLM 接入 LMCache
vLLM 通过 LMCacheConnectorV1 接入,业务代码零改动;前缀 KV 自动分层到 WQS,集群全局共享。
与 vLLM + LMCache 集成
灵活的部署形态
统一软件内核、多形态交付,兼容 vLLM / SGLang / LMCache / Mooncake / Dynamo / NVIDIA CMX
纯软件
标准 x86 服务器 + 本地 NVMe SSD 与 200G+ RoCE 网卡。最小部署:单节点 16 核 / 48GB 内存,无需专用元数据盘。部署门槛最低。
DPU + JBOF(高性能)
WQS 完全运行于 NVIDIA BlueField DPU,主机 CPU 100% 释放给推理业务。2U 机箱 4× DPU + 26× NVMe,提供高达 800Gbps × 4 的带宽,单 TB 成本大幅降低。
整机一体机交付
预装 WQS 的集成存储服务器——开箱即用,深度调优与认证的硬件,统一运维控制台,战略合作保障 SSD 供应。
构建下一代智能数据基础架构,获取业务增长的新动力。
以存代算,AI 推理十倍加速,突破上下文瓶颈-ExponTech华瑞指数云